
 Visualizza metriche
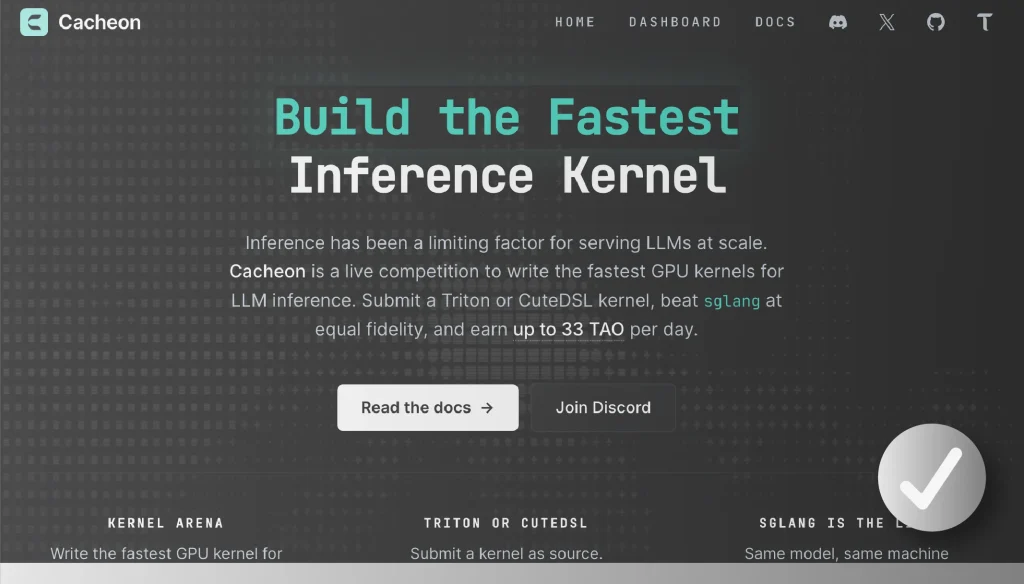
Servire modelli di linguaggio su larga scala richiede una velocità di inferenza che la maggior parte dei motori standard non riesce a offrire.
Ogni millisecondo risparmiato nell'elaborazione riduce i costi e migliora l'esperienza dell'utente, ma ottimizzare manualmente i kernel GPU è un lavoro lento, specializzato e difficile da validare.
Mancava un sistema aperto e competitivo capace di dimostrare, in modo equo, chi scrive davvero il codice più veloce.